


当观众对着屏幕喊出节奏,屏幕上的粒子便随声浪炸开、聚拢、化作星河,这不是特效电影里的桥段,而是正在走入展馆与演出的实时生成艺术。从实验室到商业现场,声音驱动视觉的创作方式,正成为艺术与技术交叉地带最活跃的实践之一。
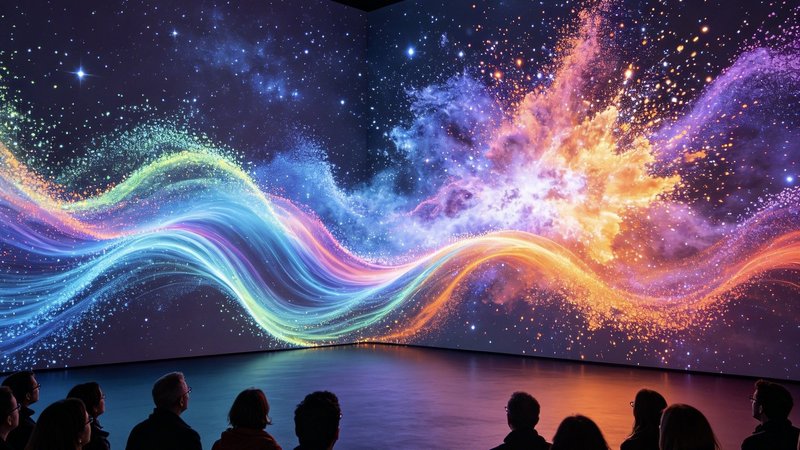
所谓声控生成艺术,核心在于「实时」二字。艺术家不再事先排好每一帧画面,而是建立一套视听映射规则,让声音的振幅、频率、节奏实时转化为色彩、形状、密度。你说话的音量放大,线条变粗;你哼唱的旋律升高,色块上移。创作者的角色,从「画出来」转向「设计规则」,而每一位观众的声音,都成为作品不可复制的变量。
这项实践的成熟,得益于生成式模型与音频分析的进步。早期的可视化工具只能做简单的频谱波形,如今借助深度学习的音频特征提取,系统可以识别音色、情绪乃至语义,视觉反馈因此更细腻。多伦多等地的新媒体艺术展上,已出现以人声为画笔、让参观者共同作画的互动装置,作品无法被两次复制,因为每一次发声都是唯一的输入。
商业应用同样在提速。品牌发布会、音乐节的舞台视觉,越来越多的现场采用了声控实时生成背景。一场电音演出里,DJ 的每一个节拍都能驱动万块像素屏同频闪烁,观众的欢呼声量甚至能改变舞台主色调,参与感被大幅拉高。对品牌而言,这不仅是视觉升级,更是一种「体验即内容」的新表达——消费者不再是旁观者,而是作品的共创者。
技术门槛的下降正在放大这一趋势。开源音频分析与实时渲染框架日渐成熟,创作者无需编写复杂底层程序,也能搭建一套自己的声画映射系统。相关研究机构数据显示,交互艺术类项目的数量在过去数年持续增长,其中声音驱动类别增速领先,印证了「听得见的艺术」的市场潜力。
当然,声控生成艺术也有隐忧。规则与算法隐藏着作者的选择,若映射逻辑过于杂乱,作品容易沦为「热闹却无味」的炫技。真正高明的创作者,懂得让声音与视觉相互成就,用克制的规则留住表达的深度。
从个人装置到公共场景,声音正成为新一代创作的画布。当技术与艺术的边界被一次次刷新,我们或许该停下来想:与其说这是机器在作画,不如说,是人类最原始的表达本能,借助算法找到了新的出口。


